Format string уязвимость: от %p до shell
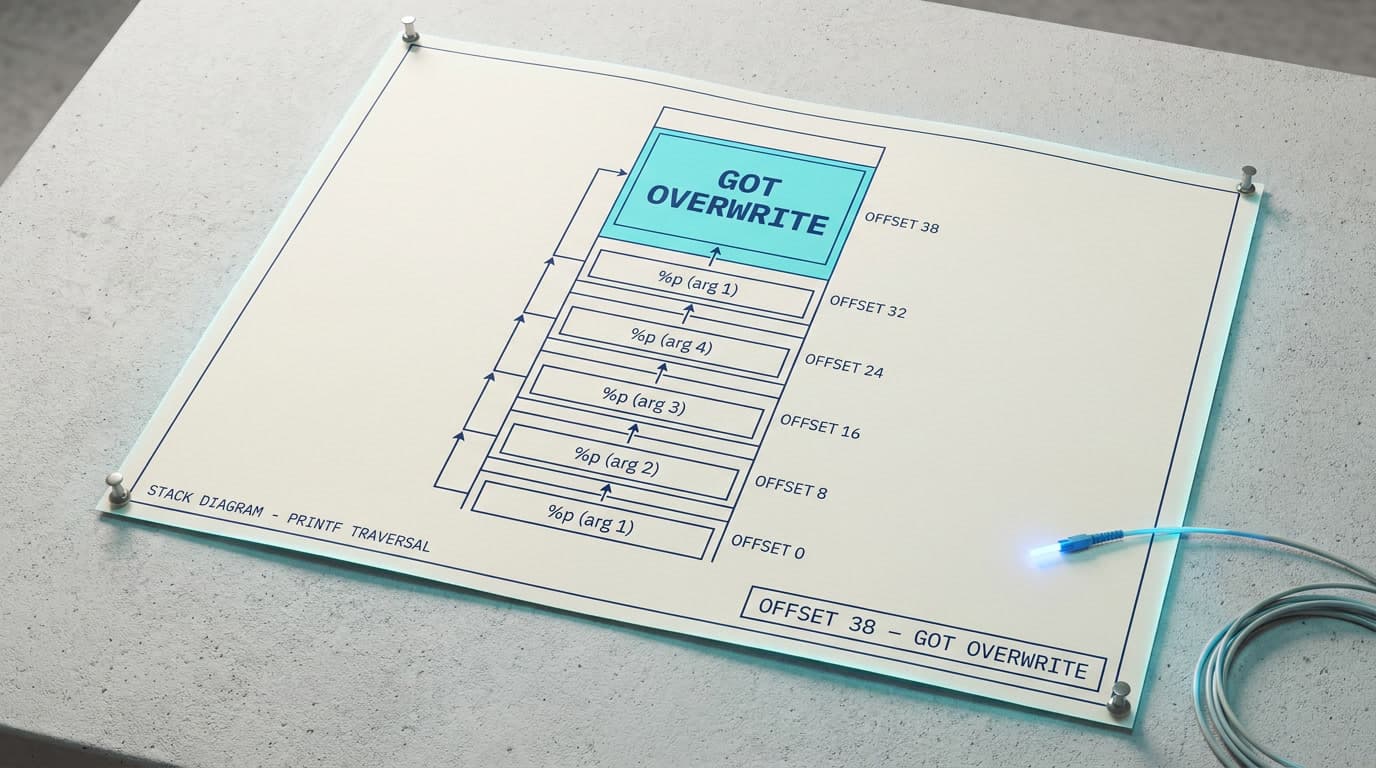
На picoCTF 2024 задача Format String 3 разделила участников на два лагеря. Первые собрали exploit за 20 минут: утечка libc через %p, вычисление base, одна строка с fmtstr_payload — shell. Вторые бились часами, собирая payload вручную, который разваливался после каждого перезапуска из-за кривого offset. Разница не в скилле — а в понимании одного механизма: как printf(buf) без фиксированного формата превращает безобидный вывод строки в полноценный arbitrary read/write примитив. Offset в той задаче — 38 позиций. Тридцать восемь. Буфер на 1024 байта между пользовательским вводом и точкой чтения printf на стеке. Ниже — полная цепочка эксплуатации format string уязвимости: от первого %p до GOT overwrite и получения shell, с разбором каждого шага, отладкой в GDB и типичными ошибками, на которых горят даже опытные участники.
Механика printf уязвимости: как один аргумент даёт arbitrary read и write
Format string атака возникает ровно в одном сценарии: программист передаёт пользовательский ввод первым аргументом в printf() или родственную функцию (sprintf, fprintf, snprintf, syslog). Функция ожидает форматную строку с описанием типов и количества последующих аргументов. Если вместо фиксированной строки приходит контролируемый буфер — атакующий диктует, что printf будет делать с памятью процесса. Подробнее — в нашем подробном разборе создание ctf заданий.
Безопасный вызов: printf("%s", buf) — строка-формат фиксирована, пользовательский ввод подставляется как данные. Уязвимый вызов: printf(buf) — ввод интерпретируется как форматная строка целиком. Разница в одном аргументе. Последствия — полный контроль над чтением и записью памяти.
По классификации OWASP это Injection (A03:2021): пользовательские данные не валидируются и интерпретируются как управляющие команды. В терминах MITRE ATT&CK эксплуатация такого бага в публичном сервисе — Exploit Public-Facing Application (T1190, Initial Access). Согласно описанию OWASP format string attack, при корректной эксплуатации атакующий может вызвать crash программы, прочитать произвольные адреса памяти, записать произвольные значения и в итоге выполнить код.
Спецификаторы формата, которые превращают printf в инструмент эксплуатации:
| Спецификатор | Действие | Тип операции |
|---|---|---|
%p |
Печатает значение со стека как указатель (hex) | Чтение (формально UB без соответствующего аргумента, на практике — безопасно для разведки) |
%x |
Печатает значение со стека как hex без префикса 0x | Чтение |
%s |
Интерпретирует значение как адрес и читает строку | Чтение (crash при невалидном адресе) |
%n |
Записывает число напечатанных символов по адресу | Запись 4 байта |
%hn |
То же, но записывает 2 байта (short) | Запись 2 байта |
%hhn |
То же, но записывает 1 байт | Запись 1 байт |
%p безопасен для разведки — просто печатает число. А вот %s — зверь опасный: если значение на стеке окажется невалидным адресом, ядро пошлёт процессу SIGSEGV, и он упадёт. На удалённом CTF-сервере это потеря соединения и переподключение. Для начальной разведки стека — всегда %p. К %s переходите, когда уверены, что по адресу лежит строка.
Утечка памяти через format string: чтение стека и адресов libc
Первый шаг при эксплуатации format string bug — чтение стека через printf. Цель двойная: найти offset (позицию собственного ввода на стеке) и вытащить адреса libc для обхода ASLR.
Минимальный уязвимый бинарник для воспроизведения всех примеров:
#include <stdio.h>
int main() {
    char buf[256];
    fgets(buf, 256, stdin);
    printf(buf);   // вот она, вся уязвимость — ввод = format string
    return 0;
}
Компиляция: gcc -fno-stack-protector -no-pie -Wl,-z,norelro -o vuln vuln.c. Флаг -fno-stack-protector убирает stack canary, -no-pie фиксирует адреса секций, -z,norelro оставляет GOT доступным для записи. Такая конфигурация — стандарт для учебных format string CTF pwn задач. В продвинутых задачах включают PIE и Full RELRO, и там вектор атаки меняется радикально.
Поиск offset: ручной метод через %p и direct parameter access
Offset — позиция на стеке, где printf находит начало пользовательского ввода. Без правильного offset ни одна запись через %n не сработает, а утечки будут читать не те данные. Это первое, что нужно найти, и первое, на чём люди застревают.
Ручной метод: вводим AAAAAAAA %p %p %p %p %p %p %p %p и ищем в выводе значение 0x4141414141414141 (ASCII-код A = 0x41, восемь байт = восемь символов A). Если это значение появилось на шестой позиции — offset равен 6. Перебирать длинную цепочку %p %p %p... — рабочий подход, но есть путь быстрее.
Синтаксис direct parameter access %N$p обращается сразу к N-му аргументу printf. Вводим AAAAAAAA %6$p — если на выходе 0x4141414141414141, значит offset = 6. Нет — пробуем 7, 8, 9 и далее. По данным курса CS6265 (Georgia Tech), без direct parameter access длина payload ограничена размером буфера: десятки %p не влезут в 64-байтный ввод, а %6$p занимает всего 4 символа. Этот же синтаксис работает с любым спецификатором: %6$x, %6$s, %6$n.
32-bit vs 64-bit: почему offset на x86_64 значительно больше
На 32-битных бинарниках offset обычно 4–7. Причина проста: все аргументы функций по cdecl передаются через стек. Пользовательский ввод лежит близко к точке чтения printf, буквально через несколько слов.
На 64-битных — чаще 6–10 и выше. По System V AMD64 ABI первый аргумент printf (форматная строка) уходит в rdi, следующие пять variadic-аргументов — в rsi, rdx, rcx, r8, r9. Только начиная с шестого variadic-аргумента printf переходит к чтению со стека. Между регистровыми аргументами и пользовательским буфером на стеке может лежать куча данных: локальные переменные, сохранённые регистры, фреймы других функций.
В задаче picoCTF 2024 Format String 3 offset составлял 38. Тридцать восемь позиций — и это реальная задача на соревнованиях, не синтетический пример. Если вы перебираете %N$p и дошли до 15 без результата — не сдавайтесь, продолжайте. На одном CTF я дошёл до 42, прежде чем увидел свои 0x41.
Что конкретно извлекается через утечку стека:
- Адреса функций libc — для вычисления libc base и обхода ASLR. Утечённый адрес
setvbuf,__libc_start_mainили любой другой функции минус её known offset даёт base - Stack canary — обычно распознаётся по нулевому младшему байту (
\x00), нужен для обхода stack protector при комбинации format string + buffer overflow - Адреса возврата — для понимания layout стека и потенциальной перезаписи return address
- Содержимое локальных переменных — в простых задачах флаг лежит прямо на стеке как строка, и
%N$sчитает его напрямую (да, бывает настолько просто)
%s даёт возможность читать не только стек, но и произвольные адреса памяти. Он интерпретирует значение на стеке как указатель и читает строку по этому адресу. Если разместить целевой адрес в своём вводе на стеке (а мы знаем его offset) и обратиться к нему через %N$s — printf прочитает содержимое этого адреса. Полноценный arbitrary read primitive. Но если значение окажется невалидным адресом — segfault и до свидания. Для безопасной разведки — %p, к %s переходите с конкретными проверенными адресами.
Автоматизация в pwntools: класс FmtStr предоставляет метод leak_stack(offset, prefix=b'') для чтения значений со стека по конкретному offset. На соревнованиях ручная проверка через %N$p занимает 30 секунд и даёт абсолютную уверенность в результате — на CTF часто предпочитаю руками, а автоматику подключаю только для записи.
Перезапись памяти printf: спецификатор %n и побайтовая запись
Спецификатор %n — тот самый механизм, который превращает format string из инструмента утечки в полноценный arbitrary write примитив. Он записывает по адресу, лежащему на стеке в позиции соответствующего аргумента, количество символов, которые printf уже напечатал к этому моменту. Как указано в документации OWASP: %n writes an integer to locations in the process' memory.
%n, %hn, %hhn — семейство спецификаторов записи
Три варианта отличаются объёмом записываемых данных:
| Спецификатор | Записывает | Когда использовать |
|---|---|---|
%n |
4 байта (sizeof(int)) | Быстрая запись 4-байтных значений |
%hn |
2 байта (short) | Запись 2-байтных фрагментов |
%hhn |
1 байт (char) | Побайтовая запись — максимальная гибкость |
Для большинства CTF-задач %hhn — рабочая лошадка. Запись полного 8-байтного адреса (например, system() = 0x7ffff7c58750) через %hhn требует 6 отдельных побайтовых операций, но каждая полностью контролируема и предсказуема. Через %n можно записать 4 байта за раз, но для значения 0x7ffff7c5 нужно набрать ~2 миллиарда напечатанных символов — printf честно попытается их все напечатать. На практике это может занять от нескольких минут до бесконечности в зависимости от скорости вывода и сети, часто нарушая таймауты CTF-серверов. Подсказки с pwn.college подтверждают: %hhn подходит для точечной перезаписи отдельных байтов, что на практике проще и быстрее.
Контроль записываемого значения через ширину поля
Количество напечатанных символов управляется через спецификатор ширины. Запись %100c заставляет printf напечатать один символ, дополненный пробелами до ширины 100 — итого 100 напечатанных символов. После %100c%N$hhn по адресу N-го аргумента будет записано значение, равное текущему счётчику printf (включая всё, что было напечатано до %100c).
Как описано у Vickie Li (vickieli.dev), width-controlling format specifiers позволяют избежать экстремально длинных exploit-строк и записывать произвольные целые числа без набивки реальных символов.
Алгоритм ручной побайтовой записи через %hhn:
- Разложить целевое значение на отдельные байты. Для
system() = 0x7ffff7c58750: байты0x50,0x87,0xc5,0xf7,0xff,0x7f - Отсортировать байты по возрастанию (счётчик printf только растёт в рамках одного вызова). Если следующий байт меньше текущего счётчика — перекрутить через 256: нужно напечатать
(256 - текущий_счётчик_mod_256 + нужный_байт)символов - Для каждого байта добавить
%Ncдля набора нужного количества и%M$hhnдля записи по адресу M-го аргумента - Разместить целевые адреса (GOT + 0, GOT + 1, ..., GOT + 5) в конце payload и обратиться к ним через direct parameter access
Ручная сборка payload из шести побайтовых записей может занять десятки минут и выдать 100+ байт форматной строки. На соревнованиях это неприемлемо — и именно для автоматизации этого процесса существует pwntools. Но собрать хотя бы один payload руками стоит — иначе автоматика навсегда останется чёрным ящиком.
GOT overwrite эксплуатация: от утечки libc до shell
Global Offset Table (GOT) — таблица в ELF-бинарнике, через которую происходят вызовы функций из динамически подключённых библиотек. Когда программа вызывает puts(), управление передаётся по адресу из puts@got — ячейки GOT, содержащей реальный адрес puts в libc. Перезаписав эту ячейку адресом system(), получаем: следующий вызов puts("/bin/sh") выполнит system("/bin/sh"). Shell получен.
GOT/PLT таблицы — фундамент lazy binding в Linux: при первом вызове функции PLT-заглушка обращается к динамическому загрузчику, тот резолвит адрес и записывает его в GOT. При последующих вызовах управление идёт напрямую через GOT — без повторного резолва. Перезапись GOT-записи через format string подменяет эту цепочку раз и навсегда до завершения процесса.
Проверка защит через checksec: RELRO и PIE
GOT overwrite работает не всегда. Команда checksec ./binary покажет, стоит ли вообще пытаться:
- Partial RELRO — GOT доступна для записи. Стандарт для большинства CTF-задач начального и среднего уровня
- Full RELRO — GOT заполняется при загрузке и помечается read-only. Запись невозможна. Альтернативные цели:
__malloc_hook,__free_hook(deprecated в glibc 2.34+), return address на стеке - No PIE — адреса секций фиксированы. Адрес GOT-записи виден статически через
objdump -R ./binaryилиelf.got['puts']в pwntools - PIE enabled — адреса рандомизируются. Нужна дополнительная утечка base адреса ELF
Конфигурация Partial RELRO + No PIE — идеальная для GOT overwrite. В задаче picoCTF 2024 Format String 3 защиты были именно такими: Partial RELRO, No PIE, Canary found, NX enabled. Canary и NX не мешают format string эксплуатации: canary защищает от перезаписи стека, NX запрещает выполнение кода на стеке, но GOT overwrite обходит обе защиты — мы ничего на стеке не перезаписываем и не выполняем.
Format string exploit через pwntools и FmtStr class
Полная цепочка эксплуатации для бинарника с Partial RELRO и No PIE: утечка libc, вычисление base, перезапись GOT.
from pwn import *

elf = ELF('./vuln')
libc = ELF('./libc.so.6')
p = process('./vuln')
# 1. Тянем адрес libc через format string
p.sendline(b'%7$p')
leak = int(p.recvline().strip(), 16)
libc.address = leak - libc.sym['setvbuf']
# 2. GOT overwrite: puts -> system через FmtStr
def do_fmt(pay):
    p.sendline(pay)
    return p.recv()
# offset=6 — обобщённый пример; в picoCTF 2024 Format String 3 offset=38
fmt = FmtStr(execute_fmt=do_fmt,
             offset=6)
fmt.write(elf.got['puts'], libc.sym['system'])
fmt.execute_writes()
Разбор: ELF('./vuln') загружает бинарник и парсит GOT/PLT таблицы — elf.got['puts'] возвращает адрес GOT-записи для puts. Строка %7$p читает 7-й аргумент printf — в этом примере это утечённый адрес setvbuf из libc (многие CTF-задачи специально добавляют такой leak перед вводом). Вычитая libc.sym['setvbuf'] из утечённого адреса, получаем base libc. Класс FmtStr принимает callback execute_fmt, который отправляет payload и получает ответ. Метод write(addr, data) ставит запись в очередь, execute_writes() генерирует и отправляет финальный payload с побайтовыми записями через %hhn.
Альтернативный подход — функция fmtstr_payload(offset, writes), которая возвращает готовую байтовую строку без callback-обёртки. Удобнее для одноразовых записей в рамках одного payload, но FmtStr class даёт больше контроля при сценариях с несколькими раундами ввода.
Отладка format string атаки в GDB: типичные ошибки
Три проблемы, на которые уходит 80% времени при решении format string CTF pwn задач. Знаю, потому что сам на каждой из них терял часы.
Неправильный offset. Самая частая причина нерабочего payload. На 64-bit системах ввод выравнивается по 8 байт — лишний символ в prefix ломает всю разметку. Проверка: AAAAAAAA %6$p должен вернуть 0x4141414141414141. Если видите смещённые байты (0x4141414141414100 или 0x2541414141414141) — offset неверный или нарушено выравнивание. Добавьте или уберите padding-символы перед маркером. На 32-bit ввод выравнивается по 4 байта: AAAA %4$x должен дать 41414141.
Нулевые байты в адресах. На 64-bit адреса содержат нули в старших позициях (например, 0x00000000004040XX). Нулевой байт \x00 обрезает строку при чтении через fgets или scanf — всё после \x00 теряется. Решение: размещать адреса в конце payload, после всех %Nc%N$hhn спецификаторов. Первая часть payload — форматные спецификаторы (чистый ASCII, без нулей), вторая часть — упакованные адреса (могут содержать \x00, но printf уже обработал всю форматную строку к этому моменту). Pwntools автоматически учитывает это при генерации payload.
ASLR и необходимость двух раундов. При включённом ASLR адреса libc рандомизируются при каждом запуске. Стандартная стратегия: раунд 1 — утечка адреса libc через %N$p, вычисление base; раунд 2 — перезапись GOT с вычисленным адресом system(). Если программа даёт только один ввод (нет цикла) — нужно либо найти утечку libc в выводе до ввода (авторы CTF-задач часто специально добавляют такой leak), либо перезаписать return address вместо GOT (не требует адреса libc, если цель — jump на функцию внутри бинарника).
Визуализация стека в pwndbg и поиск проблем
GDB с расширением pwndbg — основной инструмент отладки format string. Установка: git clone https://github.com/pwndbg/pwndbg && cd pwndbg && ./setup.sh. Ставим breakpoint перед вызовом printf, вводим тестовый payload и смотрим стек:
pwndbg> b *main+42
pwndbg> r <<< "AAAABBBB %p %p %p %p"
pwndbg> stack 15
00:0000| rsp 0x7ffe1230 -> 0x7ffe1250 ('AAAABBBB...')
01:0008|     0x7ffe1238 -> 0x7f3a9e2a0 (__libc_start)
02:0010|     0x7ffe1240 <- 0x1
03:0018|     0x7ffe1248 <- 0x4242424241414141
04:0020|     0x7ffe1250 <- 0x2070252042424242
Команда stack 15 показывает 15 записей стека с адресами и значениями. Ищем 0x4141414141414141 (наши символы A) — его позиция относительно начала чтения printf и есть offset. В туториале CS6265 показано: в выводе стека видны и пользовательский ввод, и указатели на libc, и адреса GOT — всё это потенциальные цели для утечки и записи. Команда telescope в pwndbg разрешает указатели на несколько уровней вглубь, показывая куда ведёт каждый адрес. Для format string отладки это критически полезно: сразу видно, какие значения — указатели на libc, какие — локальные переменные, а какие — наш пользовательский ввод.
Защита от format string bug и компиляторные контрмеры
Со стороны разработки fix тривиален: заменить printf(buf) на printf("%s", buf). Одна правка — и уязвимости нет. По данным OWASP, полное семейство printf-функций уязвимо: printf, fprintf, sprintf, snprintf, а также менее очевидные syslog, setproctitle, err*, warn* — по данным hackinglab.cz, список длиннее, чем думают большинство разработчиков.
Современные компиляторы (gcc, clang) выдают предупреждение -Wformat-security при передаче non-literal format string. Флаг -Werror=format-security превращает предупреждение в ошибку компиляции и полностью блокирует уязвимый паттерн. Дополнительные меры:
- Full RELRO (
-Wl,-z,relro,-z,now) — делает GOT read-only после загрузки и блокирует GOT overwrite - PIE (
-fPIE -pie) — рандомизирует адреса всех секций бинарника, усложняя адресацию - FORTIFY_SOURCE (
-D_FORTIFY_SOURCE=2) — заменяетprintfна__printf_chk, которая проверяет format string на наличие%nпри несоответствии количества аргументов - Stack canary (
-fstack-protector-all) — не защищает от format string напрямую, но затрудняет перезапись return address
В терминах MITRE D3FEND эксплуатация format string через сетевой сервис (T1190) детектируется через Protocol Metadata Anomaly Detection (D3-PMAD) — аномальные последовательности %p, %x, %n в пользовательском вводе. На уровне WAF/IDS сигнатуры на спецификатор %n в HTTP-параметрах — базовая и рабочая защита.
Согласно Mandiant M-Trends 2025, эксплойты остаются самым распространённым вектором initial access — 38% всех инцидентов. Format string баги — часть этой категории. Их доля в современных приложениях снижается благодаря компиляторным предупреждениям и статическому анализу, но в CTF-контексте они остаются фундаментальной техникой binary exploitation. Понимание механики printf переносится на все задачи с arbitrary write примитивом: heap exploitation, use-after-free, type confusion — везде ключевой навык один: контролируемая запись по контролируемому адресу.
Format string уязвимость — лучший учебный полигон для понимания работы памяти в целом. Это убеждение формировалось годами решения pwn-задач. Buffer overflow учит перезаписывать один адрес возврата. Format string заставляет думать о стеке как о структуре данных, которую можно читать позиционно и модифицировать побайтово через один вызов функции. Каждый раз, когда собираешь payload с %hhn, проходишь полный цикл: анализ layout стека, вычисление смещений, сортировка записываемых байтов, контроль счётчика printf. Те же навыки нужны для heap corruption и kernel exploitation — только здесь среда предсказуемее.
Проблема в том, что большинство CTF-участников останавливаются на стадии «скопировал fmtstr_payload из writeup и получил флаг». Payload из 113 байт перезаписывает ровно 6 байт GOT-записи — но почему именно 113, почему 6, и что произойдёт если libc другой версии? Пока не соберёшь хотя бы один payload вручную через %hhn, посчитав каждый байт и каждый спецификатор ширины — автоматизация останется чёрным ящиком. Если хочешь не просто writeup, а пройти всю атаку самому — на WAPT эту цепочку проходят в течение двух модулей с лабами.
🚀 Хочешь закрепить на практике? Реши задачи по теме на HackerLab — категория «pentest-machines».
Самые популярные статьи:
Читайте также
11 мин.
5
Command Injection в CTF: поиск и эксплуатация
Пошаговый разбор OS command injection в CTF-задачах: от обнаружения уязвимости до reverse shell. Обход фильтров, blind injection, ANSI-C нотация, payload'ы.
15 СЕНТЯБРЬ, 2026
9 мин.
5
Стеганография для начинающих: чек-лист CTF
Пошаговый чек-лист разбора стего-тасков на CTF: от file и strings до LSB-анализа. Команды binwalk, steghide, zsteg, exiftool с реальными примерами.
14 СЕНТЯБРЬ, 2026
13 мин.
7
SSRF уязвимость в CTF: обход фильтров на практике
Обход blacklist и whitelist фильтров SSRF, gopher-протокол до RCE, кража облачных токенов и blind SSRF — с конкретными пейлоадами для CTF-задач
14 СЕНТЯБРЬ, 2026
0 комментариев
Пожалуйста, войдите, чтобы оставить комментарий.
Загрузка комментариев...