Bash скрипты для CTF: перебор, парсинг, флаги
За три часа джеопарди-турнира прошлой весной наша тройка закрыла 14 задач из 20. Восемь из них — bash-скриптами, набитыми прямо в терминале за 2-3 минуты. На оставшиеся шесть ушло больше времени, чем на все автоматизированные вместе: копировали вывод из одного окна в другое, перебирали варианты через браузер, теряли флаги в хаосе файлов. Разница не в сложности задач. Разница — в количестве рутины, которую пожирает ручной ввод. Эта статья — про конкретные скрипты, однострочники и паттерны, которые превращают минуты набивания команд в секунды автоматической работы.
Написание bash скриптов для автоматизации: зачем, если есть Python
Первая реакция новичка: «Зачем скрипт, если есть hydra, ffuf, AutoRecon?» Три ситуации, в которых bash незаменим. Подробнее — в нашем обзоре создание ctf заданий.
Минимальное окружение. На CTF-машине может не оказаться Python, Ruby или Go. Урезанные контейнеры — норма для jeopardy-задач. Bash есть везде, где есть терминал. LLM-агенты, кстати, проходят часть уровней OverTheWire Bandit одиночными bash-командами через SSH — именно потому что на целевой системе ничего другого нет. Хватает стандартных утилит: cat, grep, find, sort, base64.
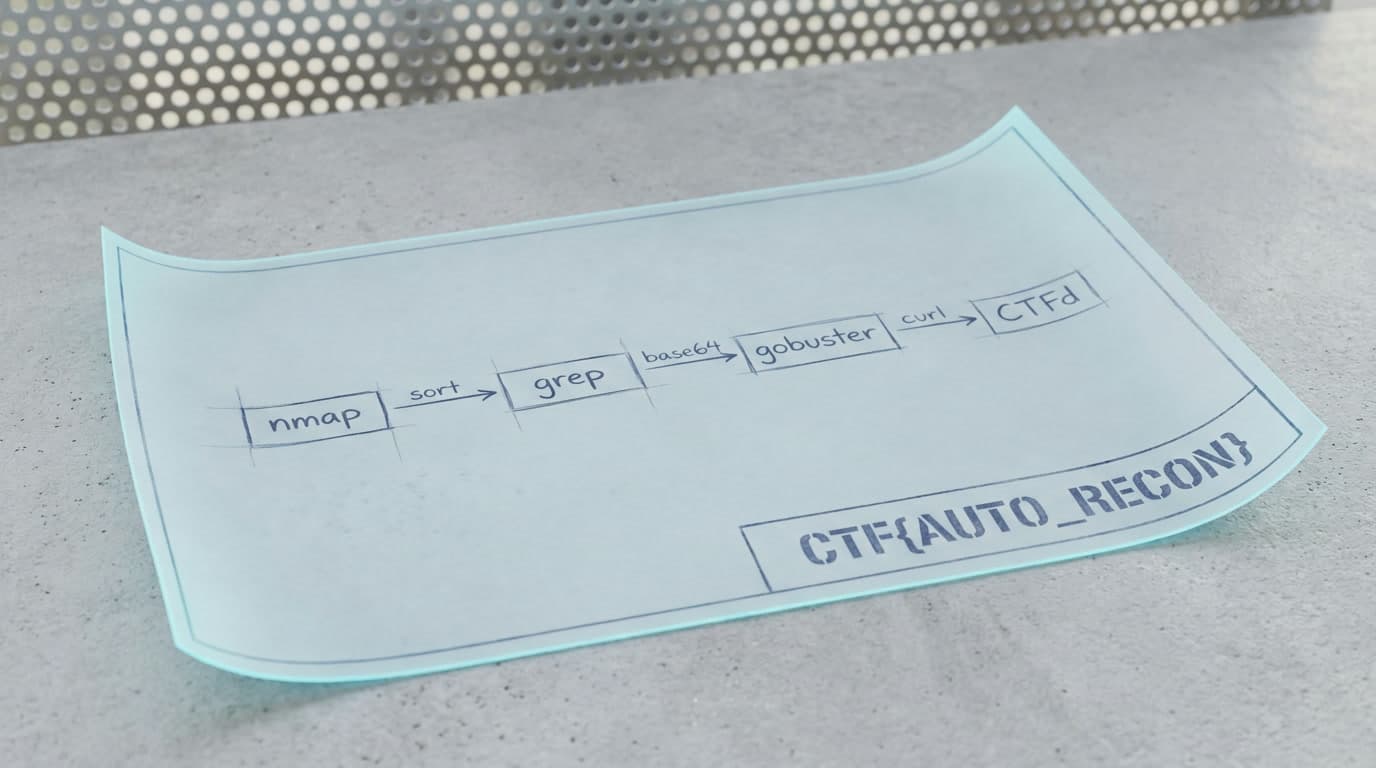
Скорость написания. Склеить nmap, grep и gobuster в цепочку — пять строк. Та же логика на Python с argparse и обработкой ошибок — 50+ строк. Когда два часа на десять задач, эта разница решает.
Bash — клей между инструментами. В терминологии MITRE ATT&CK использование bash-скриптов — техника T1059.004 (Unix Shell), тактика Execution. В тестах Atomic Red Team для этой техники есть «Create and Execute Bash Shell Script» и «Harvest SUID executable files» — оба через sh на Linux. Это ровно то, что делает участник CTF: пишет скрипт и запускает для сбора информации.
Перед первым скриптом проверьте окружение. bash --version покажет версию — подойдёт 4.x и выше. На macOS по умолчанию bash 3.2 из-за лицензионных ограничений — обновите через brew install bash. Создайте рабочую директорию mkdir ~/ctf && cd ~/ctf. Каждый скрипт начинается с шебанга #!/bin/bash и после создания делается исполняемым через chmod +x script.sh. Без этого — Permission denied. Первая граблина, через которую проходят все.
Парсинг данных в bash: grep, awk и sed для CTF
Разведка, брутфорс, сканирование — всё генерирует текстовый вывод, из которого нужно вытащить конкретные данные. grep, awk, sed и cut превращают минуты ручного ковыряния в секунды. Русскоязычные материалы обычно упоминают эти утилиты вскользь, как часть скрипта разведки. Здесь — систематический разбор паттернов, которые покрывают большинство задач на парсинг.
Регулярные выражения bash для поиска флагов
Флаг на CTF — строка определённого формата: flag{...}, CTF{...}, HTB{...}, picoCTF{...}. Поиск по файловой системе — техника T1083 (File and Directory Discovery), тактика Discovery. Атомарный тест Atomic Red Team «Nix File and Directory Discovery» демонстрирует именно этот паттерн на Linux и macOS.
Однострочник grep -rEo '(flag|CTF|HTB|picoCTF)\{[^}]+\}' /home/ 2>/dev/null рекурсивно ищет флаги по всем файлам в /home/. Флаг -r включает рекурсию, -E активирует расширенные регулярные выражения, -o выводит только совпадение (не всю строку). Перенаправление 2>/dev/null подавляет ошибки Permission denied для защищённых директорий.
Для бинарных файлов добавьте -a (обрабатывать бинарные как текст) или используйте strings файл | grep -E 'flag\{.*\}' — strings вытянет читаемые ASCII-последовательности из бинарника.
Извлечение столбцов и цепочки pipes
Типичная задача: из вывода nmap достать список открытых портов через запятую для передачи в следующий инструмент. awk — рабочая лошадка для табличных данных. Конструкция awk -F'/' '{print $1}' разбивает строку по разделителю / и берёт первое поле. Для /etc/passwd подойдёт cut -d':' -f1 — извлекает имена пользователей по разделителю :. cut проще awk для фиксированных разделителей, но не умеет работать с регулярными выражениями.
Для замен и трансформаций — sed. Команда sed 's/old/new/g' file.txt заменяет все вхождения подстроки. На CTF часто нужно для подготовки вордлистов: sed 's/$/@target.com/' users.txt добавляет домен к каждому имени, генерируя список email-адресов.
# Порты из nmap в строку через запятую
grep '/tcp.*open' scan.txt | awk -F'/' '{print $1}' | tr '\n' ','
# Флаги из файловой системы
grep -rEo '(flag|CTF|HTB)\{[^}]+\}' /home/ 2>/dev/null
# Email из HTML-страницы
grep -oP '[a-zA-Z0-9._%+-]+@[a-zA-Z.-]+\.[a-z]{2,}' page.html
# Уникальные IP из лога доступа
awk '{print $1}' access.log | sort -u
# Base64-декодирование из файла
cat encoded.txt | base64 -d
Каждая строка — самостоятельный инструмент. Комбинация через пайпы (|) — суть bash-подхода: вывод одной команды становится входом для следующей. Принцип простой: каждая утилита в пайпе делает одну вещь. Не запихивайте всю логику в одну команду awk — сломается, отлаживать невозможно. Цепочка cat log.txt | grep "ERROR" | awk '{print $3}' | sort | uniq -c | sort -rn | head -5 выглядит длинной, но каждый элемент прозрачен: фильтрует ошибки, достаёт третий столбец, считает уникальные значения, сортирует по убыванию, берёт топ-5. Уберите любой элемент — остальные не нарушатся.
Автоматизация перебора bash через curl в цикле
Веб-форма с паролем из вордлиста или числовым PIN без rate-limiting — классика CTF начального уровня. В терминологии MITRE ATT&CK это T1110.001 (Password Guessing), тактика Credential Access. Отсутствие ограничений на частоту попыток входа — проявление недостаточной защиты аутентификации, соответствует API2:2023 (Broken Authentication) из OWASP API Security Top 10. На CTF — намеренная слабость. В продакшене — дыра, за которую бьют по рукам.
Перед скриптом разберите запрос вручную. Откройте Developer Tools (вкладка Network), отправьте заведомо неверный пароль, зафиксируйте четыре вещи: URL формы, метод (POST/GET), имена полей (username, password), текст ответа при ошибке (Access denied). Проверьте наличие rate-limiting, CAPTCHA или блокировки по IP — при их наличии добавьте sleep между запросами. Без этих данных скрипт стреляет вслепую.
#!/bin/bash
URL="http://target:8080/login"; FAIL="Access denied"
while read -r pass; do
  code=$(curl -s -o /tmp/resp.txt -w "%{http_code}" \
    --data-urlencode "user=admin" \
    --data-urlencode "pass=${pass}" "$URL")
  [ "$code" = "429" ] && { sleep 5; continue; }
  resp=$(cat /tmp/resp.txt)
  echo "$resp" | grep -q "$FAIL" \
    || { echo "[+] Пароль: $pass"; break; }
  sleep 0.1  # задержка для обхода rate-limiting
done < wordlist.txt
Конструкция while read -r pass читает файл строка за строкой. Флаг -r запрещает bash интерпретировать обратные слэши — без него пароль test\n123 превратится в testn123. Конструкция < wordlist.txt стоит после done — синтаксическая особенность, к которой просто надо привыкнуть.
Почему --data-urlencode вместо -d? Потому что он автоматически URL-кодирует символы вроде &, =, % и пробелы, которые иначе ломают структуру application/x-www-form-urlencoded тела запроса. Например, & в пароле будет интерпретирован как разделитель полей — и всё, пароль уехал. Ещё нюанс: curl -d интерпретирует значение, начинающееся с @, как путь к файлу — для паролей с @ в начале это создаёт проблему. Флаг -s подавляет прогресс-бар.
Проверка через grep -q "$FAIL": флаг -q переводит grep в тихий режим, устанавливая только код возврата (0 при совпадении, 1 — нет). Оператор || выполняет блок { echo; break; } когда grep не находит строку ошибки — ответ другой, пароль подошёл.
Одинарные кавычки вместо двойных — граблина, на которую наступают стабильно. В 'user=admin&pass=${pass}' переменная не раскрывается и летит на сервер буквально как текст ${pass}. Обидно терять на это 15 минут во время турнира.
Для числового PIN замените while read на for pin in $(seq -w 0000 9999); do — флаг -w добавляет ведущие нули. Без него seq генерирует 1 вместо 0001, и четырёхзначный PIN не совпадёт. -w — флаг GNU coreutils; на macOS/BSD он может отсутствовать. Переносимая альтернатива: for pin in $(printf '%04d\n' $(seq 0 9999)); do. Подход работает до 10 000-50 000 вариантов. Для больших объёмов берите hydra (SSH, FTP, HTTP Basic Auth) или Python с requests.Session() для сложной логики с CSRF-токенами.
Сбор флагов CTF скрипт: отправка результатов в CTFd
Вот что почти никто не автоматизирует — и зря. На джеопарди-CTF с 20-30 задачами флаги разбросаны по файлам разных скриптов. Собрать вручную, скопировать в браузер, вставить в форму CTFd — на последнем часе эта рутина превращается в чистый хаос.
#!/bin/bash
# Сбор флагов и отправка в CTFd (пример концепции)
CTFD="http://ctfd.local"; TOKEN="your_token"
CHALL_ID="${1:?Укажите ID задачи}"
grep -rEoh '(flag|CTF)\{[^}]+\}' ./results/ 2>/dev/null \
  | sort -u | while read -r flag; do
  echo "[*] Найден: $flag"
  curl -s -X POST "$CTFD/api/v1/challenges/attempt" \
    -H "Authorization: Token $TOKEN" \
    -H "Content-Type: application/json" \
    -d "{\"challenge_id\":$CHALL_ID,\"submission\":\"$flag\"}"
done
Скрипт рекурсивно ищет все флаги в директории ./results/, убирает дубли через sort -u и отправляет каждый через API CTFd. Конструкция ${1:?Укажите ID задачи} — защита от запуска без аргумента: bash выведет сообщение об ошибке и завершится с кодом 1. Эндпоинт /api/v1/challenges/attempt — стандартный для CTFd; токен авторизации берётся в настройках профиля платформы.
На практике удобнее разделить сбор и отправку. Первый скрипт собирает флаги в файл (grep ... > flags.txt), второй отправляет. grep иногда ловит строки-похожие-на-флаг из комментариев в коде или тестовых данных. Быстрый просмотр flags.txt занимает 10 секунд — зато спасает от отправки мусора.
Для множественных задач оберните вызов в цикл по ID: for id in 1 2 3 5 8; do ./submit.sh "$id"; done. Запускаете — и идёте решать следующую задачу, пока скрипт отправляет результаты предыдущих.
Linux shell для хакеров: bash one-liners на каждый день
Ниже — однострочники, которые я держу в ~/.bash_aliases и вызываю на каждом CTF. Каждый решает одну задачу и легко вставляется в пайп или скрипт.
| Задача | Команда |
|---|---|
| Системная информация | uname -a; id; cat /etc/os-release |
| SUID-бинарники | find / -perm -4000 -type f 2>/dev/null |
| Записываемые директории | find / -writable -type d 2>/dev/null |
| Пользователи с shell | grep -v '/nologin' /etc/passwd |
| Cron-задачи | cat /etc/crontab; ls -la /etc/cron.d/ |
| Внутренние хосты | arp -a; ip neigh |
| HTTP-код URL | curl -o /dev/null -s -w "%{http_code}" URL |
| Перебор директорий | while read d; do curl -so /dev/null -w "%{http_code} $d\n" "http://t/$d"; done < dirs.txt |
| Base64-декодирование | echo 'строка' \| base64 -d |
| ROT13 | echo 'текст' \| tr 'A-Za-z' 'N-ZA-Mn-za-m' |
Сбор системных данных через uname, id, cat /etc/os-release — техника T1082 (System Information Discovery), тактика Discovery. Атомарный тест Atomic Red Team «List OS Information» делает ровно это через sh на Linux. Поиск SUID-бинарников — прямое соответствие тесту «Harvest SUID executable files» из Atomic Red Team для T1059.004.
Каждый найденный SUID-бинарник стоит прогнать через GTFOBins (gtfobins.github.io). Там рецепты эксплуатации для bash, awk, base64, cat, busybox и десятков других — конкретные шаги эскалации привилегий. find + GTFOBins = стандартный этап пост-эксплуатации на CTF.
Однострочник для проверки HTTP-кода (curl -o /dev/null -s -w "%{http_code}" URL) — основа для скрипта перебора директорий. -o /dev/null сбрасывает тело ответа, -w "%{http_code}" выводит только статус: 200 (страница есть), 301 (редирект), 404 (не найдено). Оберните в while read с вордлистом — получите простой аналог gobuster без внешних зависимостей. Медленнее? Да. Зато работает даже на самой голой машине.
Типичные ошибки скриптинга CTF, которые крадут время
Семь проблем, на которые в сумме я потратил больше часов, чем хочу признавать.
Пробелы в [ ] и кавычки. Конструкция [ "$VAR" -eq 0 ] требует пробелов вокруг скобок и оператора. Запись ["$VAR"-eq 0] даёт [: command not found. Если $VAR пуста, выражение [ $VAR -eq 0 ] без кавычек разворачивается в [ -eq 0 ] — unary operator expected. Правило: всегда оборачивайте переменные в двойные кавычки.
Переводы строк в переменных. После VAR=$(cat file.txt) переменная содержит переводы строк, но echo $VAR (без кавычек) схлопывает их в пробелы. echo "$VAR" — вот правильный вариант. Это ломает парсинг многострочного вывода чаще, чем кажется.
Отсутствие set -euo pipefail. По умолчанию bash продолжает работу после ошибки. Скрипт запустил nmap с опечаткой в IP, получил пустой вывод, пошёл парсить пустой файл — молча, без единого предупреждения. set -euo pipefail в начале: -e прерывает при ненулевом коде возврата, -u ругается на неопределённые переменные, -o pipefail передаёт код ошибки через пайпы. Но имейте в виду: set -e имеет документированные исключения для if-блоков и конструкций с ||/&& — это не универсальный try/catch, о чём предупреждает и документация GNU Bash.
Отсутствие trap для очистки. Скрипт создаёт временные файлы с результатами, вы прерываете его по Ctrl+C — файлы остаются. mktemp для безопасного создания и trap 'rm -f "$TMPFILE"' EXIT для автоматического удаления при завершении. Без trap временные файлы накапливаются, а в них могут валяться пароли и флаги.
Бездумное 2>/dev/null. Перенаправление stderr полезно для find и grep — подавляет Permission denied. Но для curl и nmap оно вредно: ошибка подключения уйдёт в никуда, и вы будете гадать, почему скрипт молча отработал впустую. Подавляйте stderr только там, где точно знаете характер шума.
Забытый chmod +x. Упомянуто в каждом руководстве — и всё равно первая проблема каждого новичка. Альтернатива: запускать через bash script.sh без смены прав, но это не выработает привычку.
Спецсимволы в данных. Пароль с &, = или % в строке curl -d "pass=value" — проблема: & разбивает тело запроса на поля, = ломает пары ключ-значение. Значение, начинающееся с @, curl интерпретирует как путь к файлу. Решение: --data-urlencode вместо -d. Это избавляет от целого класса ошибок при переборе вордлистов.
Автоматизация CTF: полная цепочка от разведки до флага
Bash-скрипт не существует в вакууме. Типичная цепочка на jeopardy-CTF: разведка → эксплуатация → пост-эксплуатация → сбор флага. На каждом этапе автоматизация экономит время.
Разведка. Скрипт запускает nmap с нужными флагами, парсит результат через grep и awk, передаёт открытые порты в gobuster. Для пассивной разведки — обёртки над subfinder или theHarvester со сведением результатов через sort -u. Техники T1083 (File and Directory Discovery) и T1082 (System Information Discovery) покрываются однострочниками из таблицы выше.
Эксплуатация. Брутфорс HTTP-формы через curl в цикле. Фаззинг параметров: перебираете GET-параметры, сравниваете длину ответа с базовой через wc -c. Разница в длине — сервер обработал параметр, есть точка входа для дальнейшего исследования.
Пост-эксплуатация. SUID-сканирование, чтение /etc/passwd, поиск конфигов с паролями через grep -ri 'password\|secret' /etc/ 2>/dev/null. Каждый найденный бинарник из GTFOBins — потенциальный вектор эскалации.
Сбор. Скрипт собирает флаги, дедуплицирует, отправляет в CTFd. На финальном часе, когда руки промахиваются мимо клавиш, автоматизация последнего шага — разница между «сдали вовремя» и «забыли два флага».
Для множественных целей оборачивайте pipeline в while read -r ip; do ./recon.sh "$ip"; done < targets.txt. Запускаете и идёте читать условия следующих задач.
Со стороны защиты подобные действия детектируются. В Sigma-репозитории SigmaHQ для T1059.004 есть правила lnx_shell_susp_commands.yml и lnx_auditd_susp_cmds.yml, ловящие подозрительные команды в auditd-логах. Контрмера D3FEND D3-EAL (Executable Allowlisting) блокирует запуск неавторизованных скриптов. На CTF-машинах эти меры обычно отключены намеренно — но при переходе от CTF к реальным проектам их стоит держать в голове: то, что вы пишете для атаки, ваш будущий SOC будет ловить теми же правилами.
Большинство CTF-задач начального и среднего уровня решаются скриптами в 5-15 строк. Не нужен фреймворк — нужно уметь быстро склеить три команды через пайп. Я постоянно вижу, как новички тратят полчаса на «правильный» Python-скрипт с классами и обработкой исключений для задачи, которая решается за 90 секунд одним while read. Обратная сторона: если скрипт перерос 30 строк и в нём появились вложенные циклы с парсингом JSON — это сигнал переключаться на Python. Bash хорош для быстрой склейки, Python — для сложной логики. Держать оба инструмента наготове и переключаться без фанатизма — навык, который отличает результативного CTF-игрока от знатока одного языка. LLM-агенты, к слову, проваливаются на уровнях Bandit, требующих многошаговых сценариев с сохранением состояния между командами — именно там, где bash заканчивается и начинается полноценное программирование. Если хочется пройти путь от командной строки до первых задач системно — на IB Basics эту базу закрывают за пару месяцев без академического тона.
🚀 Хочешь закрепить на практике? Реши задачи по теме на HackerLab — категория «pentest-machines».
Самые популярные статьи:
Читайте также
14 мин.
1
Стеганография CTF: чеклист инструментов поиска
Алгоритм решения стего-тасков: zsteg, steghide, binwalk, Stegsolve, Python-скрипты. Таблица совместимости инструментов по форматам и разбор 5 типичных ошибок.
3 НОЯБРЬ, 2026
15 мин.
1
Взлом хэшей в CTF: John the Ripper и Hashcat
Пошаговый workflow подбора хэшей в CTF. Команды JtR и Hashcat, маски, правила, словари, GPU-ускорение и чек-лист отладки, если хэш не ломается.
3 НОЯБРЬ, 2026
11 мин.
6
Pwntools для начинающих: pwn на Python без боли
Сквозной разбор pwntools от checksec до remote-эксплойта. GDB-интеграция из скрипта, cyclic для offset и 3 ошибки, на которые уходит по часу.
2 НОЯБРЬ, 2026
0 комментариев
Пожалуйста, войдите, чтобы оставить комментарий.
Загрузка комментариев...