Bash скрипты для CTF: автоматизация рутины
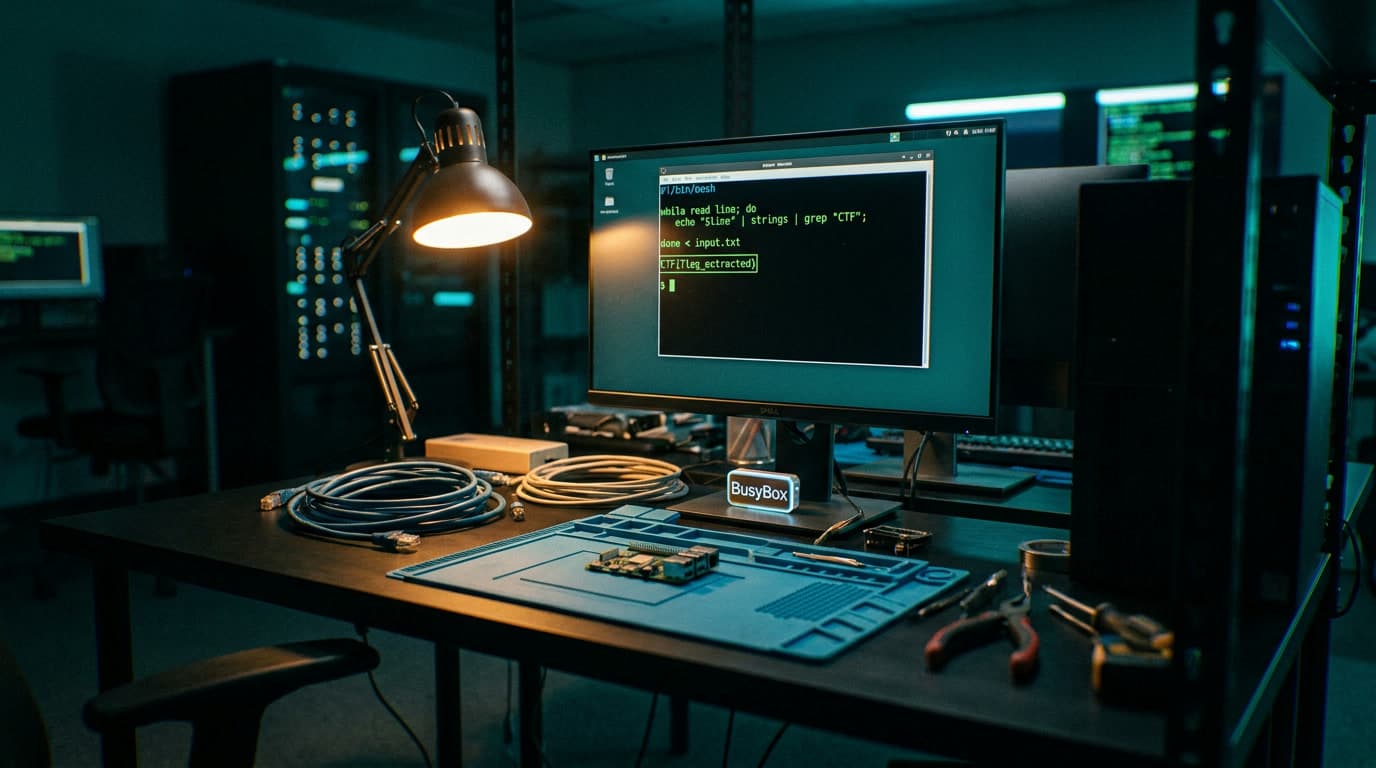
На последнем jeopardy-CTF я убил 40 минут на три задачи с одинаковой механикой: скачать файл с удалённого сервера, распаковать, прогнать через strings, выцепить флаг из вывода через grep. На четвёртой задаче разозлился, открыл nano и написал bash-скрипт на шесть строк. Оставшиеся шесть задач закрылись по три минуты каждая. Bash скрипты для CTF — не программирование в классическом смысле, а склейка утилит, которые вы и так запускаете руками, в автоматическую цепочку. Разница между 40 минутами рутины и тремя минутами результата — один цикл while read и пара пайпов. Ниже — три готовых скрипта с построчным разбором, коллекция one-liners и пять ошибок, на которые наступает каждый новичок.
Зачем bash на CTF, если есть Python и AutoRecon
Bash есть везде. На урезанных CTF-контейнерах и минимальных образах Python отсутствует, но sh, grep и wget найдутся даже в BusyBox. Я встречал задания, где на удалённой машине не было ничего кроме sh и awk — и этого хватало для полной разведки файловой системы. Подробнее — в нашем статье о создание ctf заданий.
Второй момент — скорость создания. Склеить nmap, извлечение портов и gobuster — пять строк на bash. То же самое на Python с argparse и обработкой исключений — проект на 50+ строк. Когда у тебя два часа на десять задач, эта разница решает.
И третье: bash скрипты для пентеста — прямая реализация техник из MITRE ATT&CK. Запуск shell-скриптов на целевой системе маппится на технику T1059.004 Unix Shell (тактика Execution). Разведка файловой системы через find и ls — T1083 (File and Directory Discovery). Сбор системных данных через uname, id, cat /etc/os-release — T1082 (System Information Discovery). Перебор паролей через curl в цикле — T1110.001 (Password Guessing). В тестах Atomic Red Team для T1059.004 есть сценарии «Create and Execute Bash Shell Script» и «Harvest SUID executable files» — оба выполняются через sh на Linux. Это ровно то, что делают участники CTF: пишут скрипт и запускают для сбора информации.
Автоматизация CTF через bash экономит когнитивный ресурс. Вместо набивания одних и тех же команд вы сосредотачиваетесь на логике задачи — и именно это отличает участника, закрывающего 12 задач за соревнование, от того, кто закрывает 4.
Подготовка окружения для написания bash скриптов
Перед первым скриптом проверьте три вещи.
Версия bash. bash --version — подойдёт любая 4.x и выше. На macOS по умолчанию стоит bash 3.2 из-за лицензионных ограничений — обновите через brew install bash. На Windows — WSL2 с любым дистрибутивом Linux.
Утилиты. Скрипты из этой статьи работают с nmap, gobuster, curl, grep, awk, sed и wc. В Kali Linux и Parrot OS всё стоит из коробки. На минимальных дистрибутивах доставьте через apt install nmap curl gobuster. Конкретные версии значения не имеют — используются базовые флаги, стабильные годами.
Рабочая директория и shebang. Создайте папку: mkdir ~/ctf && cd ~/ctf. Каждый скрипт начинается со строки #!/bin/bash — она указывает системе интерпретатор. После создания файла сделайте его исполняемым: chmod +x script.sh. Без этого получите Permission denied — ловушка, через которую проходит каждый новичок без исключения. Альтернатива — запуск через bash script.sh, но это менее удобно при частом использовании.
Редактор — любой: nano для начинающих, vim для тех, кто готов потратить час на привыкание к модальному режиму. На CTF скрипты часто пишут прямо в терминале через nano script.sh — поднимать GUI-редактор некогда.
Автоматизация разведки: от ручных команд к одному скрипту
Самая частая рутина на CTF — просканировать порты, определить сервисы, проверить веб-директории. Три команды, которые всегда идут друг за другом — идеальный кандидат для автоматизации рутинных задач Linux. Логика: скрипт принимает IP-адрес целевой машины, создаёт папку под результаты, запускает nmap. Если находит HTTP на каком-либо порту — автоматически натравливает gobuster для перебора директорий. Если ни один порт с HTTP не торчит наружу — скрипт ограничится только nmap-этапом.
#!/bin/bash
[ -z "$1" ] && echo "Использование: $0 <IP>" && exit 1
IP="$1"; DIR="recon_$IP"; mkdir -p "$DIR"
echo "[*] Сканирую $IP..."
nmap -sV -sC -oN "$DIR/nmap.txt" "$IP"
WEBPORT=$(grep '/tcp.*http' "$DIR/nmap.txt" | grep -oE '^[0-9]+' | head -1)
[ -n "$WEBPORT" ] && echo "[*] HTTP на :$WEBPORT, gobuster..." \
  && gobuster dir -u "http://$IP:$WEBPORT" \
  -w /usr/share/wordlists/dirb/common.txt -o "$DIR/dirs.txt" 2>/dev/null
echo "[+] Результаты в ./$DIR/"
Построчный разбор скрипта разведки
Конструкция [ -z "$1" ] проверяет, передан ли аргумент командной строки. Без неё скрипт запустит nmap без цели и зависнет в ожидании ввода — на CTF тратить на это время недопустимо.
Переменная DIR формирует имя папки вида recon_10.10.10.5, чтобы результаты каждой машины хранились отдельно и не перезаписывали друг друга. mkdir -p создаёт директорию без ошибки, если она уже существует.
Флаги nmap -sV -sC включают определение версий сервисов и запуск дефолтных NSE-скриптов. Без них nmap покажет только номера открытых портов без контекста — для CTF этого мало. Флаг -oN сохраняет результат в текстовом формате, пригодном для парсинга файлов bash-инструментами.
Дальше — самый интересный приём. Конструкция grep '/tcp.*http' находит строки вида 80/tcp open http в выводе nmap, затем grep -oE '^[0-9]+' вытаскивает номер порта из начала строки. Используются флаги GNU grep; в BusyBox флаг -oE доступен только если grep собран с опцией EXTENDED_REGEXP — на урезанных системах без неё замените на grep -o '[0-9]\+' (BRE-синтаксис). Если и -o недоступен, используйте grep '/tcp.*http' "$DIR/nmap.txt" | awk -F/ '{print $1}' | head -1 — более переносимый вариант для минимальных BusyBox-сборок. Через head -1 берём первый HTTP-порт. Если nmap не нашёл HTTP — переменная WEBPORT остаётся пустой, блок с gobuster не выполнится. Никаких ошибок, скрипт тихо завершается.
Перенаправление 2>/dev/null подавляет прогресс-бар gobuster, который засоряет терминал при автоматизированном запуске. Результаты при этом сохраняются в файл dirs.txt.
Для запуска на нескольких целях оберните вызов в цикл: while read -r ip; do ./recon.sh "$ip"; done < targets.txt. Файл targets.txt содержит по одному IP на строку. На CTF с десятком машин запускаете команду — и идёте читать условия задач, пока автоматизация пашет в фоне.
Скрипты для перебора паролей на CTF
Веб-форма авторизации без rate-limiting и CSRF-защиты — классика CTF начального уровня. Четырёхзначный PIN или пароль из короткого вордлиста. По OWASP это A07:2021 (Identification and Authentication Failures). На CTF такая слабость — намеренная часть задачи. В продакшене — дыра, за которую бьют по рукам.
Подготовка данных перед запуском брутфорса
Перед написанием скрипта разберите запрос вручную. Откройте Developer Tools в браузере (вкладка Network), введите заведомо неверный пароль и зафиксируйте четыре параметра: URL формы (например, http://target:8080/login), метод (POST или GET), имена полей (user, pass) и текст ответа при ошибке (Access denied). Без этой ручной подготовки скрипт стреляет вслепую, и вы не узнаете, сработал он или нет.
#!/bin/bash
URL="http://target:8080/login"; FAIL="Access denied"
WORDLIST="${1:-/usr/share/wordlists/rockyou.txt}"
while read -r pass; do
  resp=$(curl -s -d "user=admin" --data-urlencode "pass=${pass}" "$URL")
  if ! echo "$resp" | grep -q "$FAIL"; then
    echo "[+] Пароль найден: $pass"; exit 0
  fi
done < "$WORDLIST"
echo "[-] Совпадений нет"
Переменная FAIL содержит маркер неверного пароля — ту самую строку, которую вы зафиксировали в Developer Tools. Конструкция ${1:-/usr/share/wordlists/rockyou.txt} берёт путь к вордлисту из первого аргумента, а если он не передан — подставляет дефолтный путь к rockyou.txt, который в Kali стоит из коробки.
Цикл while read -r pass читает вордлист построчно, не загружая файл в память целиком. Это критично: rockyou.txt весит 140+ МБ, и конструкция for pass in $(cat rockyou.txt) тупо убьёт оболочку. Флаг -r предотвращает интерпретацию обратных слешей — без него пароль pa\ss превратится в pass.
curl -s -d ... --data-urlencode отправляет POST-запрос: curl автоматически объединяет несколько -d/--data-urlencode в единое тело через &, при этом --data-urlencode кодирует спецсимволы (&, =, пробелы) в значении пароля. Флаг -s подавляет прогресс-бар. Ответ сервера попадает в переменную resp, и grep -q тихо проверяет наличие строки ошибки. Если Access denied не найден — пароль подошёл, скрипт выводит результат и завершается через exit 0.
Для ускорения можно параллелизировать через xargs -P: cat wordlist.txt | xargs -P 10 -I {} curl -s -d "user=admin&pass={}" "$URL" запустит 10 потоков одновременно. Но на CTF это редко нужно — задачи проектируются под короткие вордлисты, где линейный перебор укладывается в секунды.
Если задача требует перебора SSH или FTP — проще взять hydra: hydra -l admin -P wordlist.txt ssh://target. Одна строка, без скриптов. Написание bash скриптов для хакинга веб-форм нужно для нестандартных случаев, где hydra не справляется из-за кастомного формата ответа или многошагового процесса аутентификации.
Парсинг файлов и подготовка данных в bash
Третий блок CTF-рутины — обработка файлов. Скачать архив, распаковать, найти среди сотен вложенных файлов тот, где спрятан флаг. Вручную это занимает вечность. Командная строка Linux для CTF решает задачу за секунды через конвейеры.
Поиск флагов в файловой системе
Классика: где-то на машине валяется файл с флагом формата flag{...} или CTF{...}. Команда grep -rn 'flag{' /home/ 2>/dev/null рекурсивно ищет строку, показывает имя файла и номер строки. Перенаправление 2>/dev/null подавляет ошибки доступа к защищённым директориям. Добавьте --include='*.txt' для поиска только по текстовым файлам: grep -rn --include='*.txt' 'flag{' / 2>/dev/null.
Для поиска по атрибутам — find. Файлы, изменённые за последний час: find / -type f -mmin -60 2>/dev/null. SUID-файлы — классический вектор повышения привилегий, в Atomic Red Team для T1059.004 есть тест «Harvest SUID executable files»: find / -perm -4000 -type f 2>/dev/null. Файлы с нестандартными расширениями: find . -name '*.enc' -o -name '*.b64' -o -name '*.hex'.
Пакетная обработка скриптов для подготовки файлов CTF
На соревнованиях часто дают архив с вложенными файлами или серию URL для скачивания. Скрипт ниже автоматизирует полный цикл: стягивает файлы по списку, определяет тип каждого, распаковывает архивы и ищет флаги.
#!/bin/bash
DIR="ctf_loot"; mkdir -p "$DIR" && cd "$DIR"
while read -r url; do
  f=$(basename "$url"); curl -sO "$url"
  file "$f" | grep -qi 'zip' && unzip -qo "$f" 2>/dev/null
  file "$f" | grep -qiE 'gzip|tar' && tar xf "$f" 2>/dev/null
done < ../urls.txt
grep -rn 'flag{' . 2>/dev/null
find . -name '*.txt' -exec grep -l 'CTF{' {} \;
echo "[+] Обработка завершена, файлы в $DIR/"
Скрипт читает urls.txt построчно, скачивает через curl -sO (флаг -O сохраняет файл с оригинальным именем). Команда file определяет тип содержимого по магическим байтам, а grep -qi ищет маркеры архивов без учёта регистра. Если файл — ZIP, идёт распаковка через unzip, если tar/gzip — через tar xf. Финальные строки проходят по всем извлечённым файлам, выискивая паттерны флагов обоих форматов. Концептуально это близко к T1119 (Automated Collection) — автоматическому сбору данных. T1119 в MITRE ATT&CK формально охватывает разные платформы, но в Atomic Red Team тесты для неё реализованы только под Windows (command_prompt, powershell), так что прямая валидация на Linux через Atomic tests недоступна.
Конвейеры grep, awk и sed для CTF-задач
Парсинг файлов bash-утилитами — хлеб командной строки Linux для CTF. Паттерны, которые я использую на каждом соревновании:
Вытащить все IP-адреса из текстового файла: grep -oE '[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}\.[0-9]{1,3}' file.txt | sort -u. Регулярка ищет четыре группы цифр через точку, sort -u убирает дубликаты.
Открытые порты из вывода nmap в строку через запятую: grep '^[0-9]' nmap.txt | cut -d'/' -f1 | tr '\n' ',' | sed 's/,$//'. Цепочка из четырёх утилит: grep берёт строки портов, cut отрезает /tcp, tr заменяет переводы строк на запятые, sed убирает финальную запятую. Результат: 22,80,443 — готовая строка для подстановки в другие инструменты.
Декодирование base64: base64 -d encoded.txt > decoded.txt. Несколько закодированных строк: while read -r line; do echo "$line" | base64 -d; done < encoded.txt. Hex-данные: xxd -r -p hex.txt > binary.out.
Частотный анализ слов (полезно для криптозадач): cat file.txt | tr ' ' '\n' | sort | uniq -c | sort -rn | head -20. Конвейер разбивает текст на слова, сортирует, считает повторения и выводит топ-20 по убыванию.
Bash one-liners для пентестеров: рабочая шпаргалка
Не каждую задачу стоит оформлять в полноценный скрипт. Bash one-liners для пентестеров часто решают задачу быстрее.
Перебор поддоменов через DNS: while read -r sub; do host "$sub.target.com" | grep -v 'NXDOMAIN' && echo ">> $sub"; done < subdomains.txt — делает DNS-запрос для каждой строки из файла и фильтрует несуществующие записи.
HTTP-коды списка URL: while read -r url; do code=$(curl -so /dev/null -w '%{http_code}' "$url"); echo "$code $url"; done < urls.txt | grep -v '^404' — выводит код ответа для каждого адреса, отсеивая 404. Флаг -w '%{http_code}' заставляет curl показать только статус.
Генерация PIN-кодов: seq -w 0000 9999 > pins.txt — создаёт вордлист всех 4-значных PIN с ведущими нулями. Без флага -w значение 0042 превратится в 42, а это другой пароль.
Мониторинг изменений страницы: while true; do curl -s http://target/page | md5sum; sleep 5; done — каждые 5 секунд считает хеш содержимого. Если строка изменилась — на странице обновление. Помогает ловить динамические флаги и ротацию ключей на CTF.
Извлечение строк из бинарников: for f in *; do echo "=== $f ==="; strings "$f" | grep -iE 'flag|key|pass'; done — проходит по всем файлам в директории, извлекает читаемые строки и фильтрует потенциально значимые.
Быстрый ping-sweep сети: for ip in 192.168.1.{1..254}; do (ping -c 1 -W 1 "$ip" &>/dev/null && echo "$ip up") & done; wait — проверяет каждый IP в подсети параллельно с таймаутом 1 секунда. & перед done запускает каждый ping в фоне, wait дожидается завершения всех процессов.
Извлечение email-адресов: grep -oE '[a-zA-Z0-9._%+-]+@[a-zA-Z0-9.-]+\.[a-zA-Z]{2,}' dump.txt | sort -u — regex для email, результат без дубликатов. Полезно при анализе утечек и дампов баз данных.
Пять ошибок новичков в bash скриптах для CTF
Забытый chmod +x. Создали файл, запустили ./script.sh — получили Permission denied. Решение: chmod +x script.sh или запуск через bash script.sh. Вторая ошибка встречается даже чаще первой.
Пропущенные кавычки вокруг переменных. Конструкция if [ $var == "test" ] упадёт, если $var содержит пробел или пуста — bash подставит аргументы неправильно. Всегда оборачивайте: if [ "$var" == "test" ]. На CTF переменные часто содержат спецсимволы из парсинга — без кавычек скрипт ломается непредсказуемо, и отладка занимает больше времени, чем написание.
for вместо while read для больших файлов. Конструкция for line in $(cat bigfile.txt) загружает весь файл в память и разбивает по пробелам, а не по строкам. Вордлист на 14 миллионов записей (rockyou.txt) убьёт оболочку. Правильный вариант: while read -r line; do ... done < file.txt — построчное чтение без расхода памяти.
Отсутствие проверки зависимостей. Скрипт вызывает nmap, а nmap не установлен — на выходе пустые файлы и ломаные фильтры дальше по цепочке. Добавляйте в начало: command -v nmap >/dev/null || { echo "nmap не найден"; exit 1; }. Две строки, которые экономят час отладки.
Жёстко прописанные значения вместо аргументов. Скрипт с TARGET="10.10.10.5" в теле вместо TARGET="$1" — одноразовый. На CTF один скрипт запускается на десяти машинах. Используйте аргументы ($1, $2) и дефолты через ${1:-значение}. Это не усложняет код — это делает его переиспользуемым.
Организация библиотеки bash скриптов для CTF
После нескольких соревнований у вас накопится десяток скриптов. Организуйте их правильно с самого начала — хаотичная папка с файлами типа script2_final_v3.sh через месяц превращается в помойку, где ничего не найти.
Создайте структуру: ~/ctf/bin/ для исполняемых скриптов, ~/ctf/lib/ для общих функций. Файл ~/ctf/lib/common.sh содержит переиспользуемые конструкции: проверку аргументов, цветной вывод, функции логирования. Подключение из любого скрипта — одна строка: source ~/ctf/lib/common.sh.
Добавьте ~/ctf/bin/ в переменную PATH: строка export PATH="$HOME/ctf/bin:$PATH" в ~/.bashrc. После этого вызывайте скрипты по имени из любой директории: recon.sh 10.10.10.5 вместо ~/ctf/bin/recon.sh 10.10.10.5.
Инициализируйте git-репозиторий через git init в ~/ctf/. Версионирование позволяет откатывать неудачные изменения и переносить всю коллекцию на новую машину через git clone. На CTF это особенно ценно: клонируете репозиторий на свежую виртуалку — и полный арсенал доступен за секунду.
Шаблон нового скрипта: shebang, проверка аргументов, проверка зависимостей, комментарий с описанием назначения. Четыре строки преамбулы, которые стоит копировать в каждый файл. Это не формализм — через месяц вы откроете скрипт и за две секунды вспомните, зачем он нужен.
Для параллельной работы с несколькими целями используйте tmux. tmux new-session -s ctf создаёт сессию, Ctrl+B % делит окно вертикально, Ctrl+B " — горизонтально. Одна панель — скрипт разведки, вторая — мониторинг логов, третья — ручная работа. На соревнованиях с несколькими машинами одна панель на каждую цель — параллельная разведка без переключения между терминалами.
За полтора года участия в CTF я пришёл к одному наблюдению: 80% задач начального и среднего уровня решаются десятком bash-скриптов и двумя десятками one-liners. Не потому что задачи простые — рутина в них одинаковая. Скачай, распакуй, найди, отправь. Разница между участниками, которые закрывают 12 задач за соревнование, и теми, кто закрывает 4 — не в знаниях. Знания примерно одинаковые на этом уровне. Разница — в автоматизации. Один набирает nmap -sV -sC -oN ... руками на каждой машине и ждёт. Другой запускает скрипт и через 90 секунд читает готовые результаты.
Вижу повторяющуюся ошибку: новички пытаются «выучить bash» как отдельную дисциплину. Читают книжки по 600 страниц, проходят академические курсы по shell scripting от A до Z. Для CTF не нужен весь bash. Нужны while read, grep -oE, curl -s -d, пайпы и условие [ -n "$var" ]. Шесть конструкций покрывают 90% задач. Остальное гуглится в моменте, когда задание требует чего-то нестандартного. Важнее привычка автоматизировать до второго повторения: если команду набрали дважды — это сигнал написать скрипт. Не красивый, не идеальный — рабочий. Три строки, которые экономят десять минут, ценнее элегантного решения на 50 строк, которое вы напишете «когда-нибудь потом». Если хотите выстроить базу системно и не тыкаться по разрозненным гайдам — курс IB Basics на codeby.school берёт с нуля до первых рабочих задач, без академического тона.
🚀 Хочешь закрепить на практике? Реши задачи по теме на HackerLab — категория «pentest-machines».
Самые популярные статьи:
Читайте также
13 мин.
3
JWT-атаки в CTF: none, слабый секрет и confusion
Пошаговый разбор 3 атак на JWT в CTF: alg:none, брутфорс секрета hashcat -m 16500, algorithm confusion RS256→HS256. Команды jwt_tool и ручная сборка.
23 ОКТЯБРЬ, 2026
14 мин.
5
Стеганография CTF: binwalk, steghide и zsteg
Пошаговый алгоритм решения стего-задач на CTF: какой инструмент для какого формата, workflow от file до stegseek, Python-скрипты для LSB и дерево решений.
23 ОКТЯБРЬ, 2026
14 мин.
9
OSINT для начинающих: поиск по нику, фото и email
Пошаговые цепочки OSINT в CTF: Sherlock для ника, Holehe для email, Yandex для фото. Команды, типичные ошибки новичков и разбор таска от старта до флага.
22 ОКТЯБРЬ, 2026
0 комментариев
Пожалуйста, войдите, чтобы оставить комментарий.
Загрузка комментариев...